Domain warnsymbol.de kaufen?
Wir ziehen mit dem Projekt
warnsymbol.de um.
Sind Sie am Kauf der Domain
warnsymbol.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain warnsymbol.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ísberg, Frída: Die MarkierungDie Markierung , Was passiert, wenn Ideen zu Ideologien gerinnen? Poetisch, scharfsichtig und eindringlich erzählt Frída Ísberg von einer Gesellschaft, die per Gesetz Klarheit über Gut und Böse schaffen will. Island in naher Zukunft. Um die öffentliche Sicherheit zu erhöhen, sind bestimmte Wohngebiete nur noch für sogenannte markierte Menschen zugänglich, deren moralische Vertrauenswürdigkeit durch einen Empathie-Test nachgewiesen wurde. Bei den anstehenden Wahlen wird sich entscheiden, ob die allgemeine Markierungspflicht gesetzlich verankert wird. Ob die skeptische Lehrerin Vetur, der einflussreiche Psychologe Óli, die Geschäftsfrau Eyja oder der Schulabbrecher Tristan: Egal welchen Hintergrund sie mitbringen und egal, ob sie die gesellschaftlichen Veränderungen befürworten, hinnehmen oder aktiv gegen sie angehen - sie alle geraten in den Strudel der Verwerfungen einer Gesellschaft, deren neue Spielregeln explosive Folgen haben. , Elektromotorenteile > Elektromotoren & -teile , Erscheinungsjahr: 20220903, Produktform: Leinen, Autoren: Ísberg, Frída, Übersetzung: Flecken, Tina, Seitenzahl/Blattzahl: 288, Themenüberschrift: FICTION / Literary, Keyword: Gesellschaft; Freiheit; Entscheidung; Journalist; Hoffnung; öffentliche Überwachung; Öffentliche Sicherheit; Staatliche Kontrolle; Social Credit System; Sozialkredit-System; Gewaltfreiheit; Political Correctness; politische Korrektheit; Meinungsfreiheit; Vertrauen, Fachschema: Isländische Belletristik / Roman, Erzählung, Fachkategorie: Moderne und zeitgenössische Belletristik~Dystopische & utopische Literatur~Belletristik in Übersetzung, Region: Reykjavík, Zeitraum: 2020 bis 2029 n. Chr., Warengruppe: HC/Belletristik/Romane/Erzählungen, Fachkategorie: Control, privacy and safety in society, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 211, Breite: 133, Höhe: 29, Gewicht: 424, Produktform: Gebunden, Genre: Belletristik, Genre: Belletristik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 274772523,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ísberg, Frída: Die MarkierungDie Markierung , Was passiert, wenn Ideen zu Ideologien gerinnen? Poetisch, scharfsichtig und eindringlich erzählt Frída Ísberg von einer Gesellschaft, die per Gesetz Klarheit über Gut und Böse schaffen will. Island in naher Zukunft. Um die öffentliche Sicherheit zu erhöhen, sind bestimmte Wohngebiete nur noch für sogenannte markierte Menschen zugänglich, deren moralische Vertrauenswürdigkeit durch einen Empathie-Test nachgewiesen wurde. Bei den anstehenden Wahlen wird sich entscheiden, ob die allgemeine Markierungspflicht gesetzlich verankert wird. Ob die skeptische Lehrerin Vetur, der einflussreiche Psychologe Óli, die Geschäftsfrau Eyja oder der Schulabbrecher Tristan: Egal welchen Hintergrund sie mitbringen und egal, ob sie die gesellschaftlichen Veränderungen befürworten, hinnehmen oder aktiv gegen sie angehen - sie alle geraten in den Strudel der Verwerfungen einer Gesellschaft, deren neue Spielregeln explosive Folgen haben. , Elektromotorenteile > Elektromotoren & -teile , Erscheinungsjahr: 20220903, Produktform: Leinen, Autoren: Ísberg, Frída, Übersetzung: Flecken, Tina, Seitenzahl/Blattzahl: 288, Themenüberschrift: FICTION / Literary, Keyword: Gesellschaft; Freiheit; Entscheidung; Journalist; Hoffnung; öffentliche Überwachung; Öffentliche Sicherheit; Staatliche Kontrolle; Social Credit System; Sozialkredit-System; Gewaltfreiheit; Political Correctness; politische Korrektheit; Meinungsfreiheit; Vertrauen, Fachschema: Isländische Belletristik / Roman, Erzählung, Fachkategorie: Moderne und zeitgenössische Belletristik~Dystopische & utopische Literatur~Belletristik in Übersetzung, Region: Reykjavík, Zeitraum: 2020 bis 2029 n. Chr., Warengruppe: HC/Belletristik/Romane/Erzählungen, Fachkategorie: Control, privacy and safety in society, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 211, Breite: 133, Höhe: 29, Gewicht: 424, Produktform: Gebunden, Genre: Belletristik, Genre: Belletristik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 274772523,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
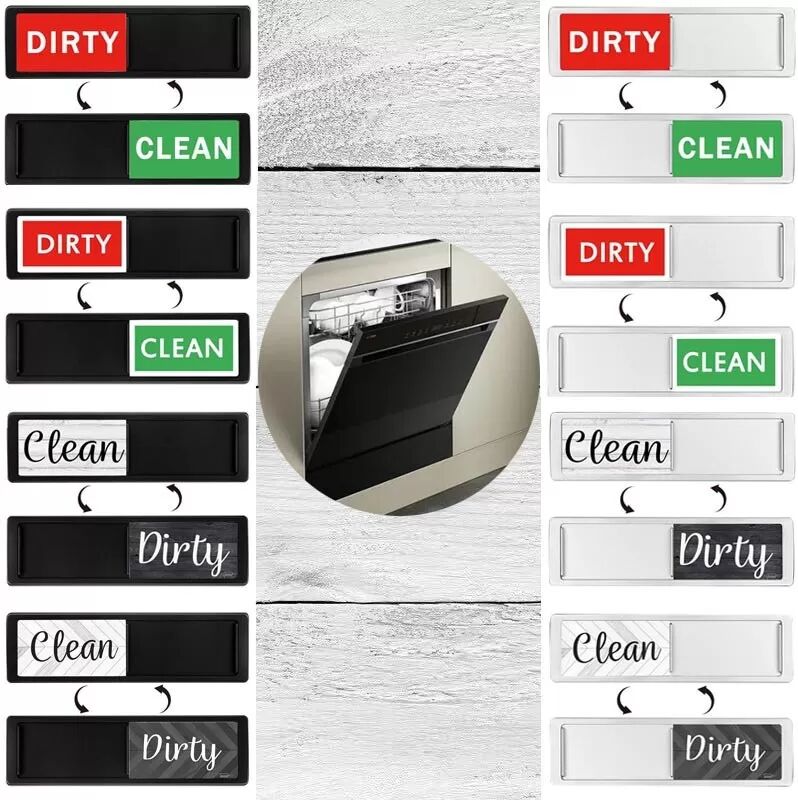
INF Geschirrspüler Magnet Sauber Schmutzig Zeichen Indikator, Doppelseitiger magnetischer Geschirrspüler AufkleberZeigen Sie mit diesem magnetischen Geschirrspülerschild deutlich sauberes oder schmutziges Geschirr an. Einfach zu bedienen, starke magnetische Haftung und aus ABS-Kunststoff. Perfekt für jede Küche, dieser Geschirrspüler-Magnet hilft, Organisation und Effizienz aufrechtzuerhalten. Klare Statusanzeige: Mit diesem Geschirrspüler-Magneten können Sie leicht erkennen, ob das Geschirr sauber oder schmutzig ist. Die klaren 'Sauber'- und 'Schmutzig'-Etiketten beseitigen jedes Rätselraten und sparen Ihnen Zeit und verhindern die versehentliche Verwendung von schmutzigem Geschirr. Dies ist besonders nützlich in vielbeschäftigten Haushalten oder Wohngemeinschaften, in denen mehrere Personen den Geschirrspüler benutzen. Die fette Schrift sorgt für Sichtbarkeit von der anderen Seite der Küche und macht ihn zu einer praktischen und bequemen Ergänzung Ihrer Küchenaccessoires. Es ist eine einfache Lösung für ein häufiges Problem, die die Küchenorganisation und -effizienz verbessert. Starke magnetische Haftung: Der Geschirrspüler-Magnet verfügt über eine vollständige magnetische Rückseite, die eine sichere und zuverlässige Befestigung an jedem Geschirrspüler gewährleistet. Diese starke magnetische Kraft verhindert, dass das Schild verrutscht oder herunterfällt, selbst wenn die Geschirrspülertür häufig geöffnet und geschlossen wird. Der Magnet ist so konzipiert, dass er an einer Vielzahl von Geschirrspülermodellen funktioniert und eine universelle Lösung zur Anzeige des Geschirrspülstatus bietet. Sein robustes Design garantiert eine lange Lebensdauer und macht ihn zu einem zuverlässigen Werkzeug zur Aufrechterhaltung der Sauberkeit und Ordnung in der Küche. Die Stärke des Magneten sorgt dafür, dass er an Ort und Stelle bleibt und eine konsistente und klare Kommunikation des Geschirrspülerstatus ermöglicht. Einfach zu bedienen: Der Geschirrspüler-Magnet ist unglaublich einfach zu bedienen. Befestigen Sie ihn einfach an der Vorderseite Ihres Geschirrspülers und drehen Sie das Schild um, um anzuzeigen, ob das Geschirr darin sauber oder schmutzig ist. Der reibungslose Klappmechanismus ermöglicht ein müheloses Umschalten zwischen den beiden Etiketten. Für die Installation sind keine Werkzeuge oder Klebstoffe erforderlich, was ihn zu einer problemlosen Ergänzung Ihrer Küche macht. Sein benutzerfreundliches Design macht ihn für alle Altersgruppen und Fähigkeiten geeignet und bietet eine einfache und effektive Möglichkeit, Geschirrspülarbeiten zu verwalten. Die intuitive Bedienung stellt sicher, dass jeder im Haushalt den Magneten leicht verstehen und verwenden kann, wodurch die gemeinsame Verantwortung und die Küchenorganisation gefördert werden. Spezifikationen: Farbe: Schwarz Abmessungen: Länge: 17,7 cm, Breite: 5,2 cm Material: ABS-Kunststoff Das Paket beinhaltet: Markierungsaufkleber x 110,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.